
Century 21をスクレイピングする方法:不動産データ抽出ガイド
Century 21から物件リスト、価格、エージェントの詳細情報をスクレイピングする方法を解説。AkamaiやCloudFrontを回避して、価値の高い不動産データを抽出しましょう。
ボット対策検出
- Akamai Bot Manager
- デバイスフィンガープリント、行動分析、機械学習による高度なボット検出。最も洗練されたアンチボットシステムの一つ。
- CloudFront
- Google reCAPTCHA
- GoogleのCAPTCHAシステム。v2はユーザー操作が必要、v3はリスクスコアリングでサイレント動作。CAPTCHAサービスで解決可能。
- IPブロック
- 既知のデータセンターIPとフラグ付きアドレスをブロック。効果的に回避するにはレジデンシャルまたはモバイルプロキシが必要。
- レート制限
- 時間あたりのIP/セッションごとのリクエストを制限。ローテーションプロキシ、リクエスト遅延、分散スクレイピングで回避可能。
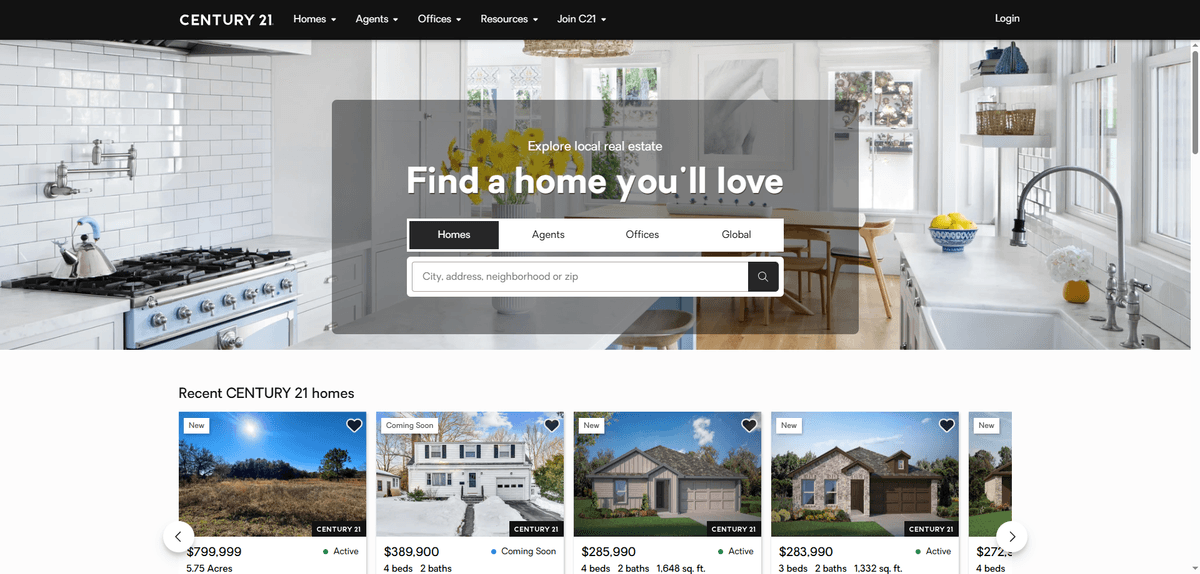
Century 21について
Century 21が提供するものと抽出可能な貴重なデータを発見してください。
世界的な不動産業界のリーダー
Century 21 Real Estate LLCは、1971年に設立された象徴的な不動産フランチャイズ企業です。Anywhere Real Estateの子会社として、80カ国以上に14,000以上の独立経営オフィスを持つ巨大なネットワークを管理しています。このプラットフォームは、住宅、商業、および高級物件の主要なハブとして機能しています。
豊富な物件データセット
ウェブサイトには、掲載価格、物件スペック(寝室数、バスルーム数、面積)、周辺地域の人口統計、過去の納税記録など、深く構造化された情報が含まれています。また、エージェントや仲介業者の連絡先やオフィスの場所を含む包括的なプロフィールも掲載されており、業界のリード獲得のための宝庫となっています。
データサイエンティストにとっての価値
投資家やプロップテック開発者にとって、Century 21のスクレイピングは評価モデルの構築、市場動向の追跡、リード発見の自動化に不可欠です。このデータを抽出することで、企業は競争優位性を獲得し、仲介業者のパフォーマンスを監視し、高収益の投資機会をリアルタイムで特定できます。
なぜCentury 21をスクレイピングするのか?
Century 21からのデータ抽出のビジネス価値とユースケースを発見してください。
不動産評価モデル
過去および現在の大量の掲載データを集計し、住宅査定や市場予測のための予測モデルを構築します。
投資機会の特定
価格の下落や新規掲載をリアルタイムで監視し、迅速な取得やフリッピング(転売)に適した割安物件を特定します。
住宅ローンおよび融資のリード獲得
最新の物件情報を追跡することで、融資や保険サービスを必要としている新しい住宅所有者や売り手を特定します。
競合他社の市場シェア
特定の郵便番号エリアでどの仲介業者やエージェントが最も多くの掲載を獲得しているかを分析し、地域の市場支配力を把握します。
超ローカルな市場トレンド
近隣レベルでの平方フィートあたりの単価や在庫レベルの変化を追跡し、クライアントに最適な購入時期をアドバイスします。
スクレイピングの課題
Century 21のスクレイピング時に遭遇する可能性のある技術的課題。
Akamaiボット防御
Century 21は、Akamaiの高度な行動分析を使用して、ヘッドレス・ブラウザや自動スクレイピングスクリプトを検出・ブロックしています。
動的コンテンツのレンダリング
このサイトは最新のJavaScriptフレームワークに依存しているため、データは静的なHTMLには存在せず、完全なブラウザ実行が必要になります。
強力なIPレート制限
同じIPアドレスからの頻繁なリクエストは、即時のブロックやCAPTCHAを誘発するため、レジデンシャル・プロキシのローテーションが必要です。
脆弱なCSSセレクター
ウェブサイトの構造やクラス名は頻繁に更新されるため、自己修復機能や堅牢なロジックを備えたスクレイパーが必要になります。
Century 21をAIでスクレイピング
コーディング不要。AI搭載の自動化で数分でデータを抽出。
仕組み
必要なものを記述
Century 21から抽出したいデータをAIに伝えてください。自然言語で入力するだけ — コードやセレクターは不要です。
AIがデータを抽出
人工知能がCentury 21をナビゲートし、動的コンテンツを処理し、あなたが求めたものを正確に抽出します。
データを取得
CSV、JSONでエクスポートしたり、アプリやワークフローに直接送信できる、クリーンで構造化されたデータを受け取ります。
なぜスクレイピングにAIを使うのか
AIを使えば、コードを書かずにCentury 21を簡単にスクレイピングできます。人工知能搭載のプラットフォームが必要なデータを理解します — 自然言語で記述するだけで、AIが自動的に抽出します。
How to scrape with AI:
- 必要なものを記述: Century 21から抽出したいデータをAIに伝えてください。自然言語で入力するだけ — コードやセレクターは不要です。
- AIがデータを抽出: 人工知能がCentury 21をナビゲートし、動的コンテンツを処理し、あなたが求めたものを正確に抽出します。
- データを取得: CSV、JSONでエクスポートしたり、アプリやワークフローに直接送信できる、クリーンで構造化されたデータを受け取ります。
Why use AI for scraping:
- ノーコード・ビジュアルビルダー: ポイント&クリックでCentury 21から複雑なデータを抽出。PythonやNode.jsによるカスタム開発は不要です。
- 組み込みのAkamai回避機能: Automatioはブラウザのフィンガープリントや行動パターンを自動的に管理し、高度なボット対策システムに検知されないようにします。
- 動的JavaScriptの実行: ツールがすべての動的なReactコンポーネントを完璧にレンダリングするため、抽出時に物件詳細や画像を見逃すことはありません。
- クラウドでの自動スケジューリング: 物件スクレイパーを毎日または1時間ごとに実行するようにスケジュールし、新しい掲載情報をデータベースやGoogleスプレッドシートに直接同期します。
- 無限スクロールとページネーション: Automatioは「もっと読み込む」ボタンや無限スクロールを標準で処理するため、数千件の掲載情報を簡単にスクレイピングできます。
Century 21用ノーコードWebスクレイパー
AI搭載スクレイピングのポイント&クリック代替手段
Browse.ai、Octoparse、Axiom、ParseHubなどのノーコードツールは、コードを書かずにCentury 21をスクレイピングするのに役立ちます。これらのツールは視覚的なインターフェースを使用してデータを選択しますが、複雑な動的コンテンツやアンチボット対策には苦戦する場合があります。
ノーコードツールでの一般的なワークフロー
一般的な課題
学習曲線
セレクタと抽出ロジックの理解に時間がかかる
セレクタの破損
Webサイトの変更によりワークフロー全体が壊れる可能性がある
動的コンテンツの問題
JavaScript多用サイトは複雑な回避策が必要
CAPTCHAの制限
ほとんどのツールはCAPTCHAに手動介入が必要
IPブロック
過度なスクレイピングはIPのブロックにつながる可能性がある
Century 21用ノーコードWebスクレイパー
Browse.ai、Octoparse、Axiom、ParseHubなどのノーコードツールは、コードを書かずにCentury 21をスクレイピングするのに役立ちます。これらのツールは視覚的なインターフェースを使用してデータを選択しますが、複雑な動的コンテンツやアンチボット対策には苦戦する場合があります。
ノーコードツールでの一般的なワークフロー
- ブラウザ拡張機能をインストールするかプラットフォームに登録する
- ターゲットWebサイトに移動してツールを開く
- ポイント&クリックで抽出するデータ要素を選択する
- 各データフィールドのCSSセレクタを設定する
- 複数ページをスクレイピングするためのページネーションルールを設定する
- CAPTCHAに対処する(多くの場合手動解決が必要)
- 自動実行のスケジュールを設定する
- データをCSV、JSONにエクスポートするかAPIで接続する
一般的な課題
- 学習曲線: セレクタと抽出ロジックの理解に時間がかかる
- セレクタの破損: Webサイトの変更によりワークフロー全体が壊れる可能性がある
- 動的コンテンツの問題: JavaScript多用サイトは複雑な回避策が必要
- CAPTCHAの制限: ほとんどのツールはCAPTCHAに手動介入が必要
- IPブロック: 過度なスクレイピングはIPのブロックにつながる可能性がある
コード例
import requests
from bs4 import BeautifulSoup

# Headers to mimic a real browser to avoid simple blocks
headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/119.0.0.0 Safari/537.36',
    'Accept-Language': 'en-US,en;q=0.9',
    'Referer': 'https://www.century21.com/'
}

url = 'https://www.century21.com/real-estate/new-york-ny/LCNYNEWYORK/'

try:
    # Using a proxy is highly recommended for Century 21
    response = requests.get(url, headers=headers, timeout=30)
    response.raise_for_status()
    soup = BeautifulSoup(response.text, 'html.parser')

    # Example: Finding property price elements
    for card in soup.select('.property-card'):
        price = card.select_one('.property-price').text.strip()
        address = card.select_one('.property-address').text.strip()
        print(f'Price: {price} | Address: {address}')
except Exception as e:
    print(f'Failed to retrieve data: {e}')
いつ使うか
JavaScriptが最小限の静的HTMLページに最適。ブログ、ニュースサイト、シンプルなEコマース製品ページに理想的。
メリット
- ●最速の実行(ブラウザオーバーヘッドなし)
- ●最小限のリソース消費
- ●asyncioで簡単に並列化
- ●APIと静的ページに最適
制限事項
- ●JavaScriptを実行できない
- ●SPAや動的コンテンツで失敗
- ●複雑なアンチボットシステムで苦戦する可能性
コードでCentury 21をスクレイピングする方法
Python + Requests
import requests
from bs4 import BeautifulSoup
# Headers to mimic a real browser to avoid simple blocks
headers = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/119.0.0.0 Safari/537.36',
'Accept-Language': 'en-US,en;q=0.9',
'Referer': 'https://www.century21.com/'
}
url = 'https://www.century21.com/real-estate/new-york-ny/LCNYNEWYORK/'
try:
# Using a proxy is highly recommended for Century 21
response = requests.get(url, headers=headers, timeout=30)
response.raise_for_status()
soup = BeautifulSoup(response.text, 'html.parser')
# Example: Finding property price elements
for card in soup.select('.property-card'):
price = card.select_one('.property-price').text.strip()
address = card.select_one('.property-address').text.strip()
print(f'Price: {price} | Address: {address}')
except Exception as e:
print(f'Failed to retrieve data: {e}')Python + Playwright
from playwright.sync_api import sync_playwright

def scrape_century21():
    with sync_playwright() as p:
        # Launching with a real browser profile to bypass detection
        browser = p.chromium.launch(headless=True)
        context = browser.new_context(user_agent='Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36')
        page = context.new_page()

        # Navigate to a specific search result page
        page.goto('https://www.century21.com/real-estate/miami-fl/LCCAMIAMI/')

        # Wait for dynamic property cards to render
        page.wait_for_selector('.property-card')

        # Extracting data
        listings = page.query_selector_all('.property-card')
        for item in listings:
            price = item.query_selector('.property-price').inner_text()
            address = item.query_selector('.property-address').inner_text()
            print(f'Home: {price}, Location: {address}')

        browser.close()

scrape_century21()Python + Scrapy
import scrapy

class Century21Spider(scrapy.Spider):
    name = 'century21'
    start_urls = ['https://www.century21.com/real-estate/los-angeles-ca/LCCALOSANGELES/']

    # Custom settings to handle anti-bot and pagination
    custom_settings = {
        'DOWNLOAD_DELAY': 2,
        'USER_AGENT': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36',
        'CONCURRENT_REQUESTS': 1
    }

    def parse(self, response):
        for card in response.css('.property-card'):
            yield {
                'price': card.css('.property-price::text').get().strip(),
                'address': card.css('.property-address::text').get().strip(),
                'beds': card.css('.property-beds strong::text').get(),
            }

        # Following pagination
        next_page = response.css('a.next-page::attr(href)').get()
        if next_page:
yield response.follow(next_page, self.parse)Node.js + Puppeteer
const puppeteer = require('puppeteer-extra');
const StealthPlugin = require('puppeteer-extra-plugin-stealth');
puppeteer.use(StealthPlugin());

(async () => {
  const browser = await puppeteer.launch({ headless: true });
  const page = await browser.newPage();

  // Using stealth to bypass Akamai/CloudFront
  await page.goto('https://www.century21.com/real-estate/san-francisco-ca/LCCASANFRANCISCO/');

  // Wait for React content to load
  await page.waitForSelector('.property-card');

  const data = await page.evaluate(() => {
    const cards = Array.from(document.querySelectorAll('.property-card'));
    return cards.map(el => ({
      price: el.querySelector('.property-price').innerText.trim(),
      address: el.querySelector('.property-address').innerText.trim()
    }));
  });

  console.log(data);
  await browser.close();
})();Century 21データで何ができるか
Century 21データからの実用的なアプリケーションとインサイトを探索してください。
予測査定エンジン
不動産開発業者は、スクレイピングしたデータを使用して、物件の将来の価値を予測するアルゴリズムを構築します。
実装方法:
- 1地域の現在および過去の掲載価格をスクレイピングする。
- 2面積や地元の学校の評価と照らし合わせる。
- 3物件の値上がりを推定するためのmachine learningモデルをトレーニングする。
Automatioを使用してCentury 21からデータを抽出し、コードを書かずにこれらのアプリケーションを構築しましょう。
Century 21データで何ができるか
- 予測査定エンジン
不動産開発業者は、スクレイピングしたデータを使用して、物件の将来の価値を予測するアルゴリズムを構築します。
- 地域の現在および過去の掲載価格をスクレイピングする。
- 面積や地元の学校の評価と照らし合わせる。
- 物件の値上がりを推定するためのmachine learningモデルをトレーニングする。
- 融資機関向けのターゲットマーケティング
住宅ローン貸付業者は、物件を掲載したばかりの所有者を特定し、借り換えや新しいローンパッケージを提案できます。
- Century 21で新しい物件を毎日監視する。
- 所有者やエージェントの連絡先、物件タイプを抽出する。
- CRM連携を通じてアウトリーチを自動化する。
- 競合仲介業者のベンチマーキング
代理店は競合他社の掲載パフォーマンスを分析し、自社の販売戦術を改善します。
- 都市内のすべての競合仲介業者の掲載件数をスクレイピングする。
- 物件が「契約中」になるまでの期間を追跡する。
- 競合他社のサービスエリアの空白地帯を特定する。
- 店舗立地の選定
商業投資家は、地域の物件価値に基づいて、新しい小売店舗に最適な場所を見つけるためにデータを使用します。
- 特定の用途地域(ゾーニング)の商業物件をスクレイピングする。
- 近隣の住宅価格を分析して地域の富裕度を測定する。
- 掲載密度をマッピングして未開拓のエリアを見つける。
ワークフローを強化する AI自動化
AutomatioはAIエージェント、ウェブ自動化、スマート統合のパワーを組み合わせ、より短時間でより多くのことを達成するお手伝いをします。
Century 21スクレイピングのプロのヒント
Century 21からデータを正常に抽出するための専門家のアドバイス。
レジデンシャル・プロキシを活用する
標準的なデータセンターのIPはすぐに特定され、ブロックされてしまいます。実際の一般家庭のユーザーを模倣するには、高品質なレジデンシャル・プロキシが必要です。
ステルス・ブラウジングの実装
オートメーションツールを使用する際は、AkamaiやCloudFrontがチェックするヘッドレス・ブラウザのフラグを隠すためのステルス・プラグインを使用してください。
リクエストの間隔を調整する(スロットリング)
高頻度のスクレイピングは避けてください。リクエスト間に2〜10秒のランダムな遅延を入れることで、人間のブラウジングパターンをシミュレートします。
XHRトラフィックの監視
ネットワークタブを調査して、内部のJSON APIリクエストを見つけます。多くの場合、データはパースしやすいエンドポイントを介してロードされています。
遅延読み込み(Lazy Loading)への対応
多くの物件詳細や画像はスクロール時にのみ読み込まれます。スクレイパーがゆっくりとスクロールを行い、データの読み込みをトリガーするようにしてください。
User-Agentのローテーション
単純なシグネチャ検知を避けるため、常に最新の実在するUser-Agent文字列のプールを使用してローテーションを行ってください。
関連 Web Scraping
How to Scrape Homes.com: Real Estate Data Extraction Guide
How to Scrape LivePiazza: Philadelphia Real Estate Scraper
How to Scrape Locations Hawaii | Locations Hawaii Web Scraper
How to Scrape HotPads: A Complete Guide to Extracting Rental Data
How to Scrape Sacramento Delta Property Management
How to Scrape RE/MAX (remax.com) Real Estate Listings
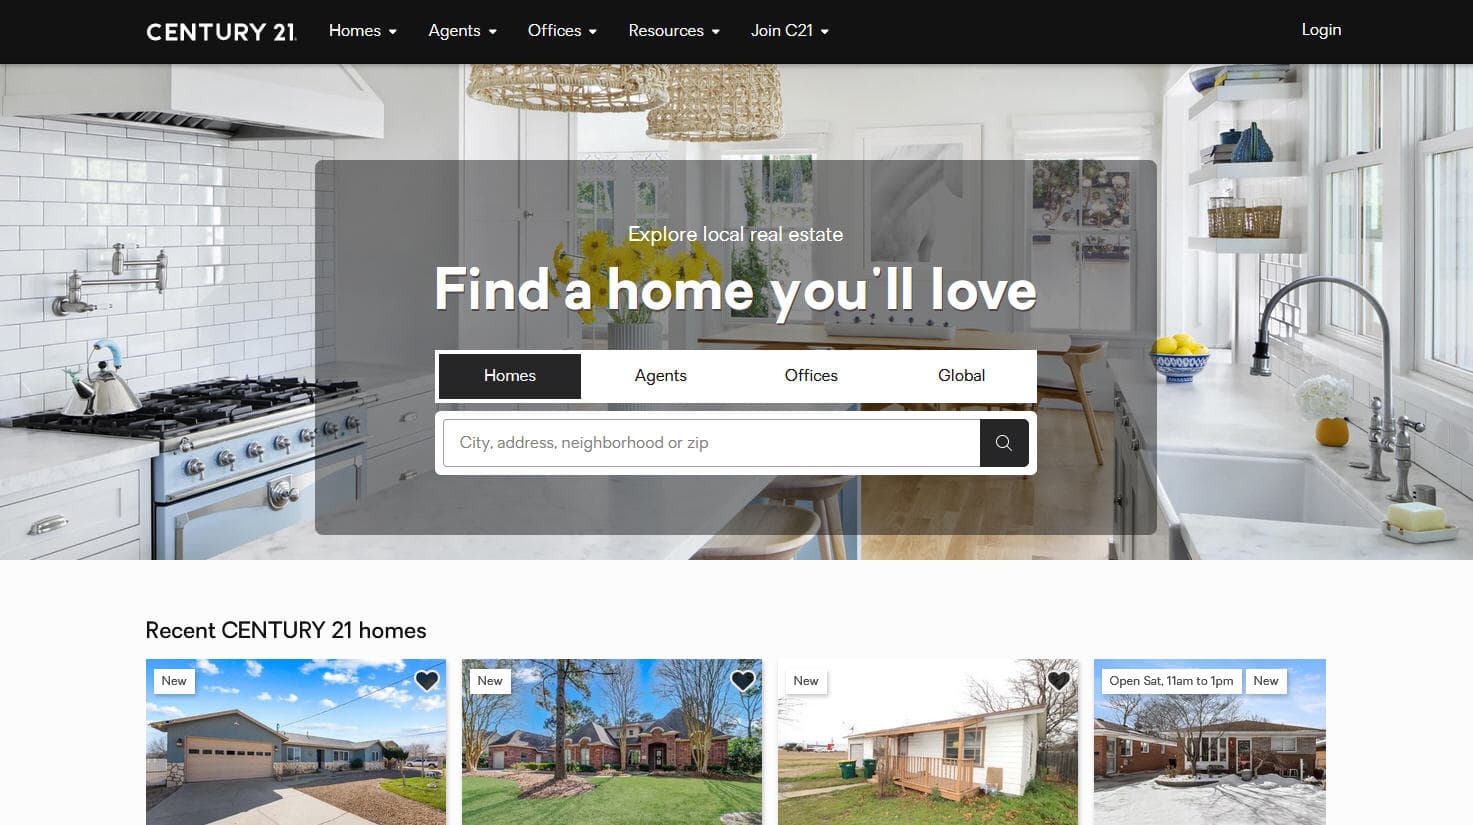
How to Scrape Century 21: A Technical Real Estate Guide
How to Scrape Apartments Near Me | Real Estate Data Scraper
Century 21についてのよくある質問
Century 21に関するよくある質問への回答を見つけてください